wiredframe: Meine Arbeit in einer Terminal-App, und ein Rückgängig, dem ich vertraue
Nach gut zehn Stunden lief die erste Version mit meinen echten Daten. Die Wochen danach gehörten vor allem einer Frage: Was passiert, wenn etwas schiefgeht?
„Gibt es fürs CLI eine Art PIM mit Mail, Kalender und Tasks?“
So fing es am 24. September an. Ich wollte eigentlich nur wissen, ob es so etwas schon gibt. Zwei Tage später hatte ich eine eigene App, und drei Wochen später läuft darüber meine komplette Selbstständigkeit: Zeiten, Rechnungen, Ausgaben, Kontoauszug, Steuern, Mail, Termine, Notizen.
Bis dahin war das über ein halbes Dutzend Programme verteilt. Zeiten in WorkingHours, Rechnungen in SubTotal, Ausgaben und Steuern in meiner eigenen App Kontor, dazu ein paar Python-Skripte und Skills für Claude. Ein Diagramm, das Claude mir davon zeichnete, sah aus wie ein Kabelsalat. Jedes Programm wusste nur seinen Teil. Welche Mail zu welchem Projekt gehörte und welche Zeit auf welcher Rechnung landete, wusste nur ich.
Ich bin kein Senior Developer. Mit Claude konnte ich trotzdem so ein Projekt angehen: Er schrieb den Code, die Tests und die Dokumentation. Ich habe entschieden, was die App können soll, sie jeden Tag benutzt und gesagt, wo es hakt. Dieser Beitrag ist eher technisch, denn das Spannende an wiredframe sieht man auf den ersten Blick kaum: wie die Daten zusammenhängen und wie viel Arbeit darin steckt, dass nichts verloren geht.
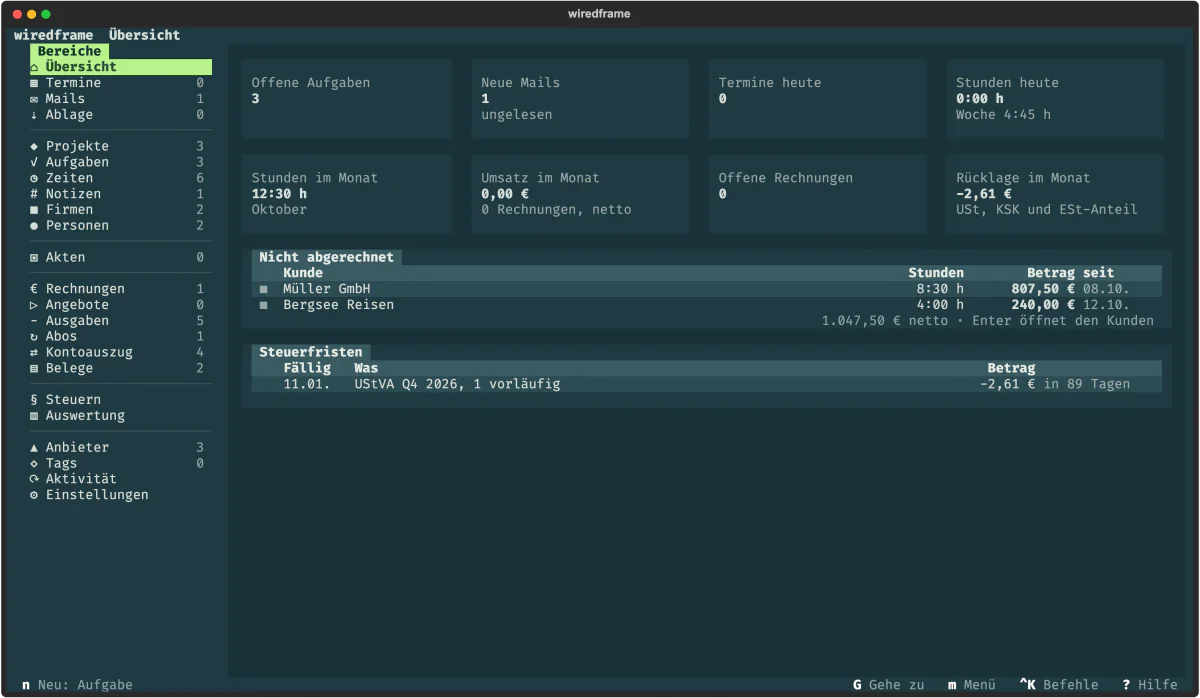
Ein Graph statt sechs Programme
Der Satz, mit dem ich Claude das Projekt beschrieben habe, steht heute noch oben in der README: The frame holds everything. The wires connect everything.
Jeder Datensatz in wiredframe, ob Kunde, Aufgabe, Zeitbuchung, Mail oder Beleg, hat eine gemeinsame Identität: eine ULID, also eine zeitlich sortierbare ID mit 26 Zeichen, adressierbar als wf:task/01M4X…. Die Fachtabellen der Module hängen mit demselben Schlüssel an einer gemeinsamen Tabelle entities.
Beziehungen zwischen Modulen heißen Wires. Ein Wire ist eine Zeile mit Quelle, Art und Ziel, Fremdschlüsselspalten über Modulgrenzen gibt es nicht. Jede Art von Wire bringt ihre Regeln mit. Eine Aufgabe gehört zu höchstens einem Projekt (max_targets). Eine Zeitbuchung wird höchstens einmal abgerechnet (max_sources). Und manche Wires sind Kontext: Sie bilden einen gerichteten Graphen ohne Kreise, den der Kern selbst bewacht.
Aus diesem Kontext entsteht das, was sich in der App „intelligent“ anfühlt. Eine Zeitbuchung kennt ihren Kunden, auch wenn dazwischen Aufgabe und Projekt liegen. Ein Projekt zeigt alle Mails, Notizen und Rechnungen, die irgendwo darunter hängen. Lege ich aus einer Mail eine Aufgabe an, landet sie automatisch im Projekt der Mail und übernimmt die beteiligten Personen.
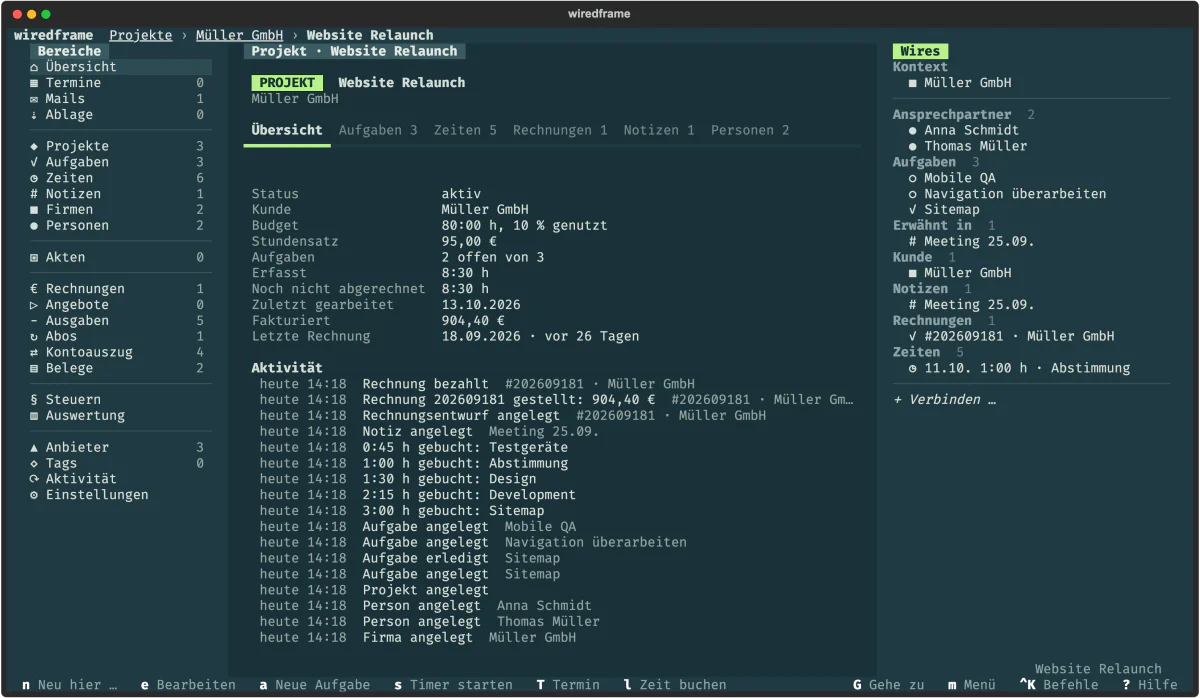
Das Wichtigste daran ist eine Regel für den Code: Die Module importieren sich nicht gegenseitig, und der Kern kennt kein einziges Modul. Ein Test prüft das bei jedem Lauf. Er weiß, welche Datei zu welchem Modul gehört und welche Tabelle wem, und schlägt Alarm, sobald irgendwo SQL auf eine fremde Tabelle zeigt oder der Kern einen Modulnamen auch nur als Text enthält. Das klingt streng. Es ist der Grund, warum ich nach drei Wochen noch Module ergänzen kann, ohne dass woanders etwas umfällt.
Ein Befehl, vier Oberflächen
Jede Funktion ist ein Command mit typisierten Parametern: Text, Datum, Dauer, Geldbetrag, Datensatz und so weiter. Daraus entstehen ohne weiteren Code das Kontextmenü, das Formular mit passenden Eingabefeldern, der Eintrag in der Befehlspalette, die Hilfe und der Aufruf über die Kommandozeile wf.
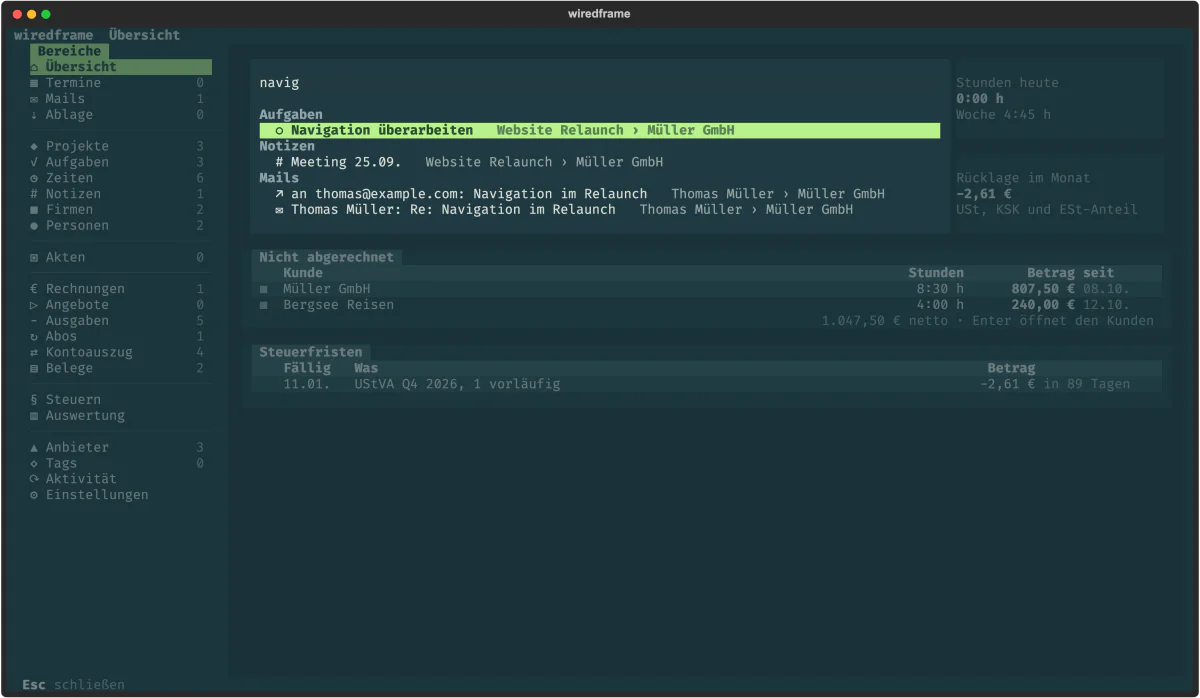
Für mich als Nutzer heißt das: Alles fühlt sich gleich an. Für Claude heißt es: Er kann alles, was ich in der Oberfläche kann, auch über wf run. Arbeitet er gerade in meinen Daten, sehe ich das unten in der Tastenleiste als „● Claude liest Rechnungen September“, und die App lädt neu, sobald er etwas geändert hat. Ein eigenes KI-Modul braucht wiredframe dadurch nicht. Für wiederkehrende Abläufe wie den Tagesabschluss, das Einsortieren von Scans oder die Steuererklärung gibt es Skills, die über die Kommandozeile arbeiten.
Die Formulare öffnen sich in der rechten Seitenleiste statt in Dialogen. Eingaben werden zentral gelesen, „1:30“, „1,5“ und „90m“ sind dieselbe Dauer, „Freitag“ ist der nächste Freitag. Gibt es einen Kunden noch nicht, bietet jedes Feld an, ihn gleich anzulegen, und springt danach zurück.
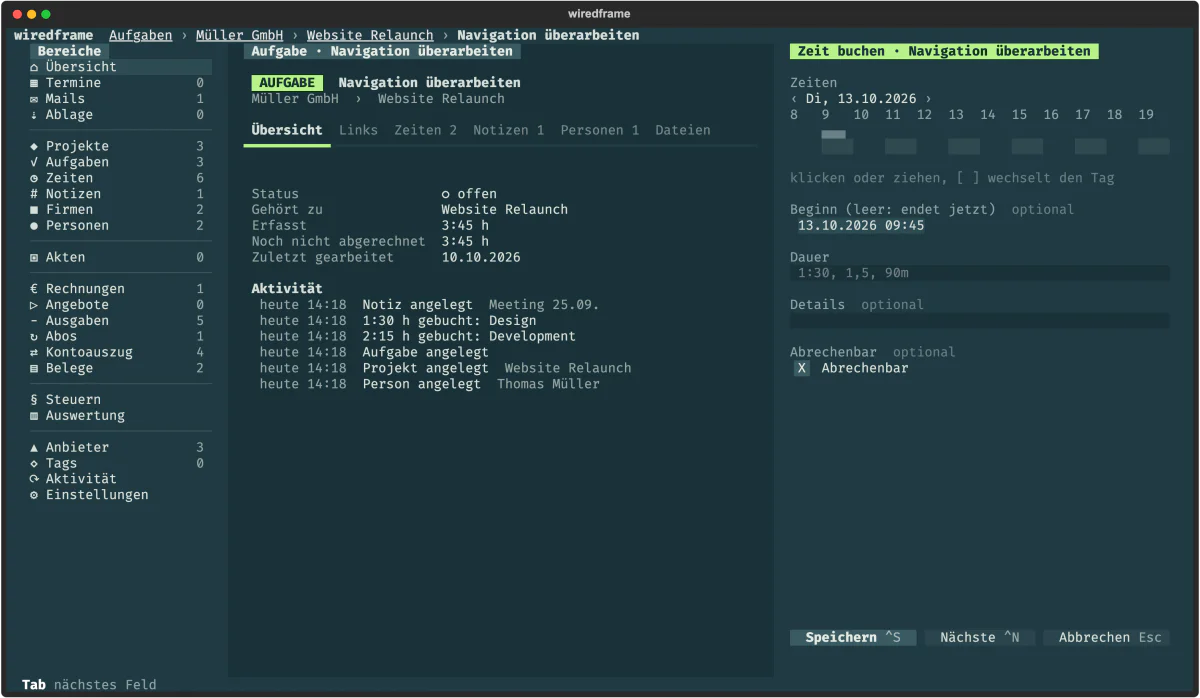
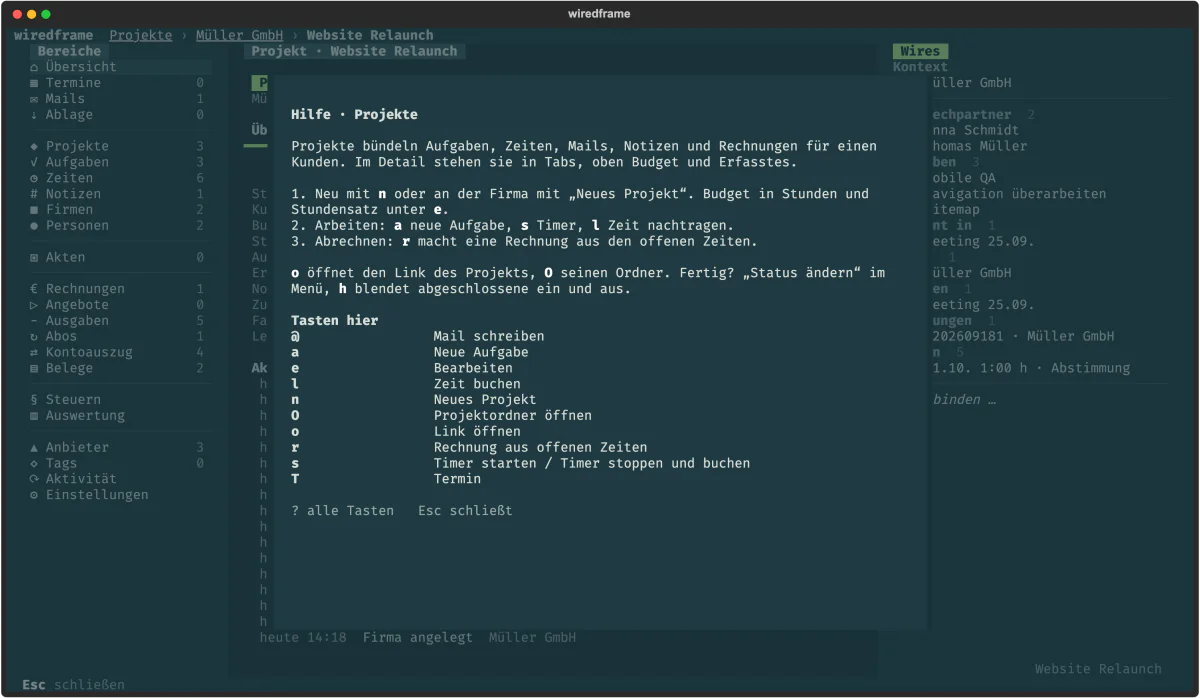
Auch die Hilfe hängt an den Befehlen. ? zeigt zu jeder Ansicht einen kurzen Text und die Tasten, die dort gelten. Die Tasten im Text sind Platzhalter, die aus den Befehlen gefüllt werden. Ändert sich die Bedienung und der Text nicht, schlägt ein Test fehl.
Von der Idee bis zum Produktivbetrieb an einem Tag
Am 26. September um 10:26 Uhr kam der erste Commit: Kern, sechs Module, Oberfläche und Kommandozeile. Um 20:46 Uhr markierten wir Version 1.0 und übernahmen meine echten Daten aus WorkingHours, SubTotal und Kontor.
Das ging so schnell, weil wir die alten Programme nicht nachbauten. Ich ließ Claude Screenshots davon machen und sie als Referenz für die Bedienung nehmen. Das Datenmodell bekam aber von Anfang an seine eigene Form. Der Import lief genau einmal und flog danach wieder aus dem Code.
Ab diesem Abend galt eine Trennung, die bis heute hält: Entwickelt wird im Projektordner, gezeigt mit Testdaten. Meine echte Installation läuft aus einem eigenen Git-Worktree auf einer markierten Version. Was Claude baut, erreicht mich erst, wenn ich es freigebe.
Geld ist kein float
Bei einer App, aus der meine Rechnungen und Steuererklärungen kommen, ist Rechnen keine Nebensache. Beträge stehen in ganzen Cent, Mengen in Tausendsteln, Steuersätze in Basispunkten (1900 sind 19 %). Gerundet wird kaufmännisch, und nirgends im Rechenweg steht eine Fließkommazahl.
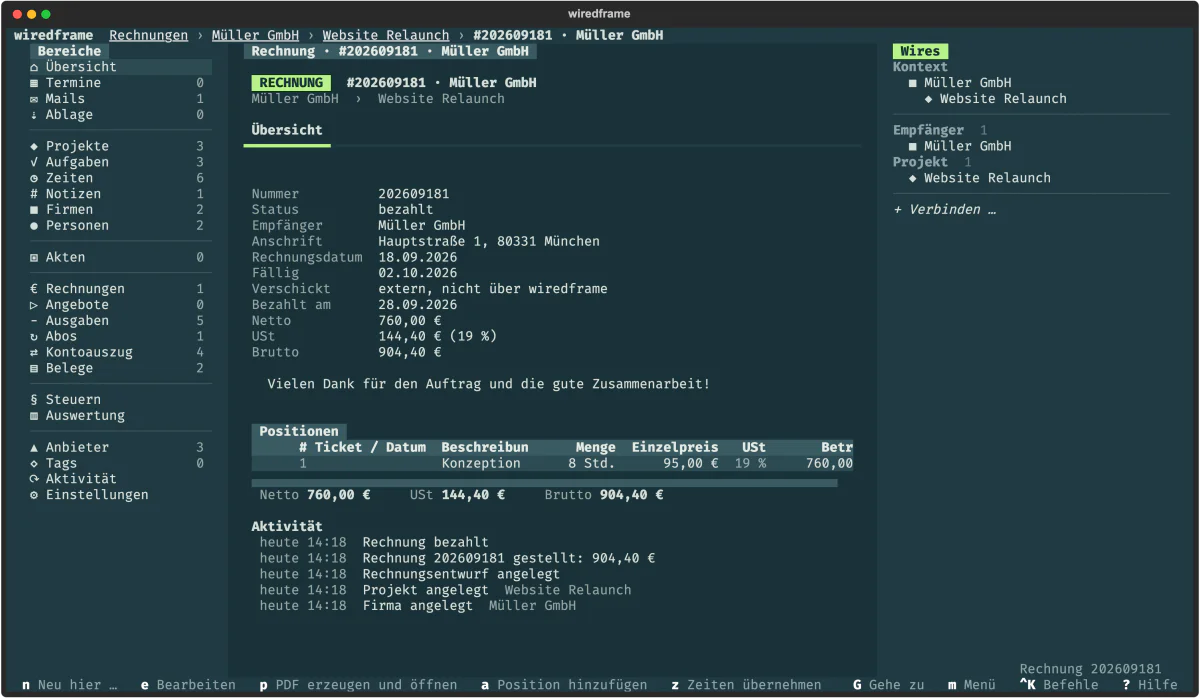
Gestellte Rechnungen schützt zusätzlich die Datenbank selbst. SQLite-Trigger sorgen dafür, dass Art und Status einer gestellten Rechnung feststehen und Nummer und Datum ab dem Versand, auch wenn jemand direkt per SQL in die Datenbank schreibt. Abgerechnete Zeiten lassen sich nur noch in der Beschreibung ändern. Die E-Rechnung nach ZUGFeRD wird vor dem Stellen gegen die offiziellen Regeln geprüft.
Die Steuerberechnung ist eine Sammlung reiner Funktionen auf Posten in Cent: Umsatzsteuer-Voranmeldung, Zusammenfassende Meldung, EÜR, Rücklage. Für die Jahreserklärung liefert wf export steuer die Zahlen, ein Skill macht daraus die Formularzeilen, und Claude füllt Mein ELSTER im Browser aus, bis kurz vor dem Absenden. Das drückt nur ich.
Dabei kam übrigens ans Licht, dass bei der Übernahme aus Kontor einige Bankbuchungen doppelt hereingekommen waren, einmal mit kurzem und einmal mit langem Schlüssel. Seit Version 1.27.1 erkennt der Import beide Schlüssel als bekannt. Ohne die Vorprüfung vor ELSTER wäre das wohl erst im Bescheid aufgefallen.
Rückgängig, ernst gemeint
Wenn ich einer App meine Buchhaltung anvertraue, will ich jeden Schritt zurücknehmen können: Tippfehler genauso wie „Rechnung angelegt“, „Kunde gelöscht“ oder „zwanzig Mails einem Projekt zugeordnet“.
So funktioniert es: Jeder Befehl läuft über Frame.run und wird als Aktion aufgezeichnet. Temporäre Trigger auf allen Fachtabellen schreiben für jede geänderte Zeile den Zustand vorher mit. Rückgängig spielt das in umgekehrter Reihenfolge zurück, in einer Transaktion, mit verzögerter Prüfung der Fremdschlüssel, weil Kaskaden Kindzeilen vor den Eltern löschen. Danach prüft PRAGMA foreign_key_check die berührten Tabellen. Passt etwas nicht zusammen, scheitert der ganze Schritt sauber, statt halb zu gelingen.
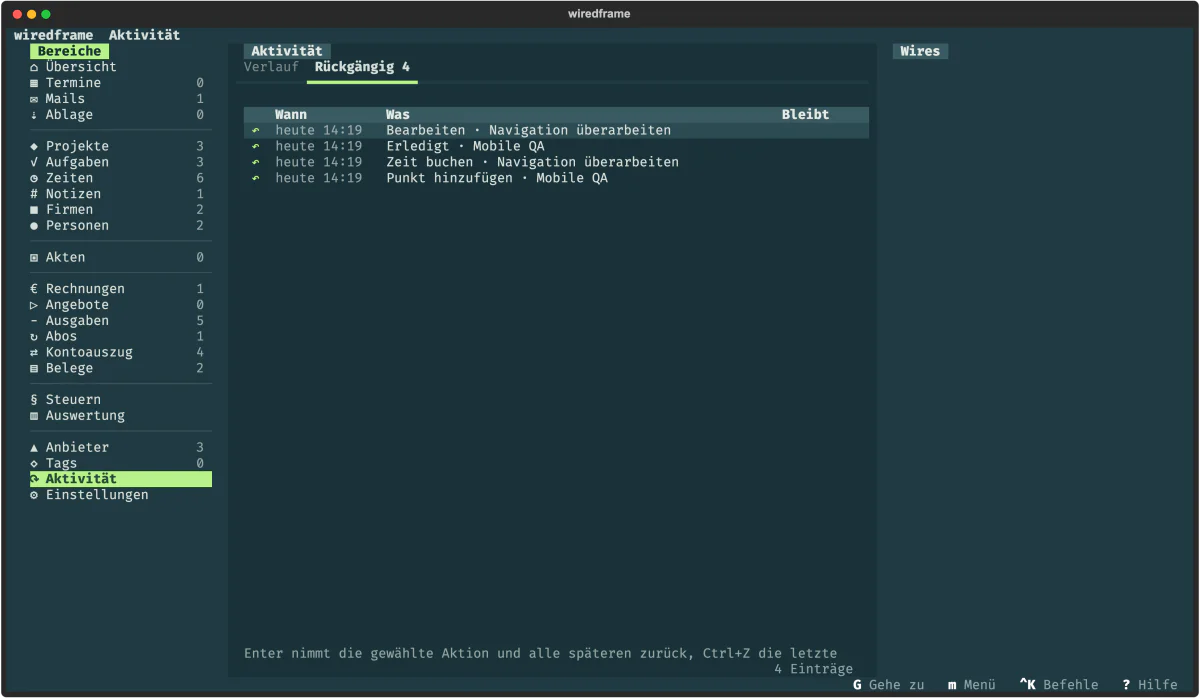
Manches lässt sich nicht zurücknehmen. Eine gesendete Mail bleibt gesendet. Solche Befehle hinterlassen eine Grenze im Stapel. Ctrl+Z hält dort an und sagt das, statt still die Aktion davor zurückzunehmen. Seit der Ablage gehören auch Dateien dazu: Wird ein Scan als Beleg einsortiert, legt Rückgängig die Datei wieder zurück, im selben Schritt wie die Datenbank. Beim Verschieben wird der Zielname exklusiv belegt, über einen harten Link oder eine exklusiv angelegte Kopie. Überschrieben wird nie etwas, auch kein kaputter Symlink.
Den wichtigsten Fehler in diesem Teil fanden wir erst am 12. Oktober, in einer Kopie meiner echten Daten. Rückgängig hatte Zeilen über ihre rowid wiedergefunden. SQLite vergibt diese Nummer aber neu, wenn vorher etwas ohne Aufzeichnung gelöscht wurde. Konkret: Ich verwerfe eine Notiz, dann gleicht der Kalender im Hintergrund einen Termin ab und bekommt dieselbe rowid. Hätte ich danach das Verwerfen zurückgenommen, wäre der Termin gelöscht worden.
Passiert ist das nie. Aber es hätte passieren können, und genau dafür ist Rückgängig da. Seitdem läuft alles über den Primärschlüssel. Für ältere Aufzeichnungen ohne Schlüssel gibt es eine vorsichtige Zuordnung über den Inhalt. Was sich so nicht eindeutig zuordnen lässt, bleibt stehen, und die Meldung sagt „1 Eintrag nicht mehr zuzuordnen“, statt Erfolg vorzutäuschen.
Sicherungen, Freigaben und Migrationen
Sicherungen laufen über die Backup-API von SQLite aus einer eigenen, nur lesenden Verbindung. Sie entstehen täglich beim Start und vor jedem Kontoauszug-Import, die letzten sieben liegen zusätzlich in meinem Vault. Auch eine Wiederherstellung sichert vorher den aktuellen Stand.
Freigegeben wird mit wiredframe update. Das Skript:
- prüft, ob die markierte Version zu der in
pyproject.tomlpasst, - bricht ab, solange die App noch läuft (ihre Rückgängig-Trigger kennen die alten Tabellen nicht),
- checkt die Version in einem frischen Worktree aus und lässt dort die komplette Testsuite laufen,
- sichert die Datenbank,
- und stellt erst dann die produktive Installation um. Danach nennt es den Weg zurück.
Schlagen die Tests fehl, ändert sich nichts. Einmal haben wir eine Version wegen Abstürzen komplett zurückgerollt. Gerade dann ist es beruhigend, dass der Weg zurück im Skript steht und nicht in meinem Kopf.
Migrationen laufen beim Start automatisch, je Modul versioniert. Vor jeder Schemaänderung gibt es eine Sicherung, und jede Migration wird vorher an einer Kopie meiner echten Daten geprüft. Auch hier fand die letzte Runde noch etwas: Starten App und wf nach einem Update gleichzeitig, wollten beide dieselbe Migration anwenden. Jetzt trägt eine Migration ihre Version zuerst und unter der Schreibsperre ein.
Für Experimente gibt es zwei Schalter. WIREDFRAME_HOME zeigt auf einen anderen Datenordner, WIREDFRAME_OFFLINE=1 lässt jeden Zugriff auf Mail, Kalender und Kontakte mit einer Meldung abbrechen. Die Tests setzen beides immer, und sie legen auch nichts in meinen echten Papierkorb. Inzwischen sind es 823 Tests, die parallel in gut 20 Sekunden durchlaufen.
Wenn draußen etwas fehlt
Viele Fehler entstehen an den Rändern der App: iCloud ist gerade nicht erreichbar, ein anderes Programm hat eine Datei geändert, ein Server antwortet halb. Eine Regel zieht sich dabei durch die ganze App: Fehlt etwas Großes, ändere nichts.
- Ist der Ordner der Ablage nicht da, weil das Laufwerk fehlt, löscht der Abgleich nicht alle Datensätze, um sie später neu anzulegen. Er tut gar nichts.
- Wirkt der Notizordner auf einmal leer, archiviert wiredframe nicht alle Notizen. Eine einzelne fehlende Datei schon.
- Liefert der Kalender eine unvollständige Antwort, entfernt der Abgleich keinen einzigen Termin.
- Habe ich eine Notiz gleichzeitig in Obsidian offen, überschreibt das automatische Speichern meine Änderungen dort nicht. Es übernimmt sie oder fragt.
- Eine CSV-Datei der Bank mit einem einzelnen Anführungszeichen ohne Gegenstück hat früher still alle folgenden Buchungen verschluckt. Jetzt fällt nur diese Zeile weg, und die Meldung sagt es.
Dazu kommen die kleinen Dinge, die man erst im Alltag merkt: der 25-Stunden-Tag am Ende der Sommerzeit, Notizen in Latin-1, Kontoauszüge in Windows-1252, bei denen aus dem Euro-Zeichen ein Steuerzeichen wurde.
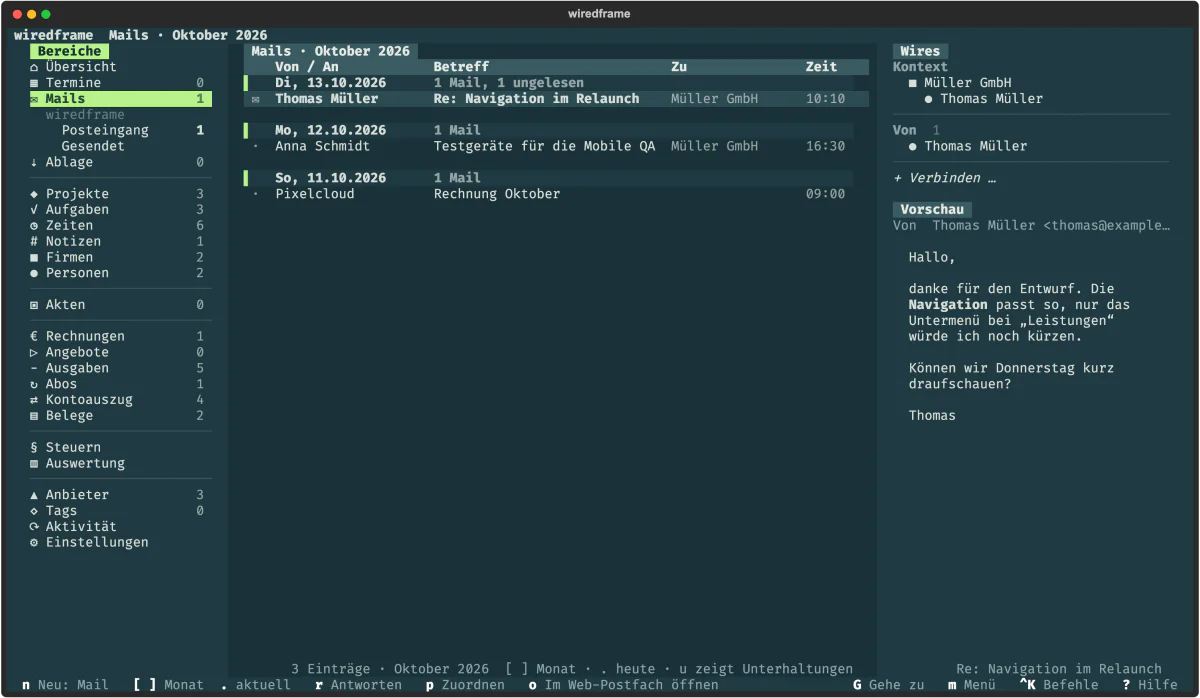
Bei Mail ging es zusätzlich um Sicherheit im engeren Sinn. Push läuft über IMAP IDLE, aber nur als Klingel: Die Verbindung ist schreibgeschützt und meldet nur, dass etwas Neues da ist, abgeholt wird über den normalen Weg. Tokens holt genau eine Stelle im Code. Und Links aus Mails öffnen nur noch Webseiten und Mail-Adressen. Vorher hätte ein file:-Link in einer Mail per Klick an open gehen und damit ein Programm starten können. Für Links aus meinen eigenen Notizen gilt inzwischen dasselbe in etwas lockerer: Ordner und gängige Dokumente gehen auf, Programme, Skripte und Pakete zeigt nur der Finder.
Nächte mit Agenten
Neben den Funktionen gab es drei große Runden, die nur Qualität zum Ziel hatten. Claude arbeitete sie über Nacht mit mehreren Agenten ab, jeder in seinem eigenen Git-Worktree und für einen Bereich zuständig.
Verschlankung (1. auf 2. Oktober). Nach einer langen Alltagsprüfung hatte ich mir „eine mächtige, aber schlanke App“ gewünscht. Das Prüfnetz dafür war ein Schnappschuss-Vergleich: Die App rendert jede Ansicht mit fester Uhr und offline, einmal mit Demodaten und einmal mit einer Kopie meiner echten Daten, vor und nach dem Umbau. Am Ende: null Unterschiede und deutlich weniger Code.
Review (5. auf 6. Oktober). Acht Agenten, einer je Bereich. Danach war der rekursive Weg durch den Kontext gut 15-mal schneller (0,35 auf 0,02 ms je Schritt), die Ausgabenliste mit über 1.200 Einträgen lud in 36 statt 215 ms. Daneben kamen viele kleine echte Fehler, bis hin zur Zeitumstellung.
Hardening (12. Oktober). Sieben Agenten, danach zwei unabhängige Prüfungen mit Fix-Runden dazwischen. Daher kommt der rowid-Fund von oben.
Bewährt hat sich eine Regel, um die ich Claude inzwischen immer bitte: Nach jeder Stufe eines größeren Vorhabens kommt eine Bugfix-Runde mit eigener Durchsicht und einer unabhängigen Prüfung durch einen zweiten Agenten, der nur liest. Bestätigte Fehler bekommen einen Regressionstest, erst dann geht es weiter. Diese Runden haben jedes Mal echte Fehler gefunden.
Ganz ohne Lehrgeld ging es nicht. Meine Einstellungen zeigen mit absoluten Pfaden in meinen Vault, für Sicherungen, Belege und Notizen. In einer Kopie der echten Daten stehen diese Pfade natürlich auch. Ein Agent hat so einmal eine Sicherung aus seiner Testkopie in meinen echten Vault gespiegelt. Passiert ist nichts, aber seitdem werden diese Pfade vor jedem Start einer Kopie umgebogen, und zwar nicht nur in den Einstellungen, sondern auch in den Tabellenzeilen, die auf Dateien zeigen.
Was ich bewusst nicht gebaut habe
Am zweiten Tag schrieb ich Claude: „Diese Überspezifizität ist zu custom tailored. Die Software sollte ja für jeden gut funktionieren, reduziert und fokussiert.“ Danach flogen der Monatsabschluss, private Budgets, ein JIRA-Export und eine Drop-Area für Belege wieder raus. Die Künstlersozialkasse wurde zu allgemeinen Vorsorgeaufwendungen.
Eine native Mac-Oberfläche haben wir sogar zweimal probiert. Der erste SwiftUI-Prototyp verlor für mich „unglaublich viel von seinem utilitarian Charme“. Am 9. Oktober ließ ich nach einem schönen Mockup trotzdem ein richtiges MVP bauen, mit wf serve als Prozess für den Datenzugriff. Das Mockup gefiel mir sehr. Die echte App war im Alltag aber nicht angenehm und nicht übersichtlich. Zwanzig Minuten nach dem Commit war alles zurückgenommen, der Versuch liegt auf einem eigenen Zweig. Für eine dichte Arbeitsoberfläche ist mir das Terminal einfach lieber.
Kleiner, aber genauso ehrlich: Zebrastreifen im Finanzamt-Theme standen genau eine Minute in einer markierten Version.
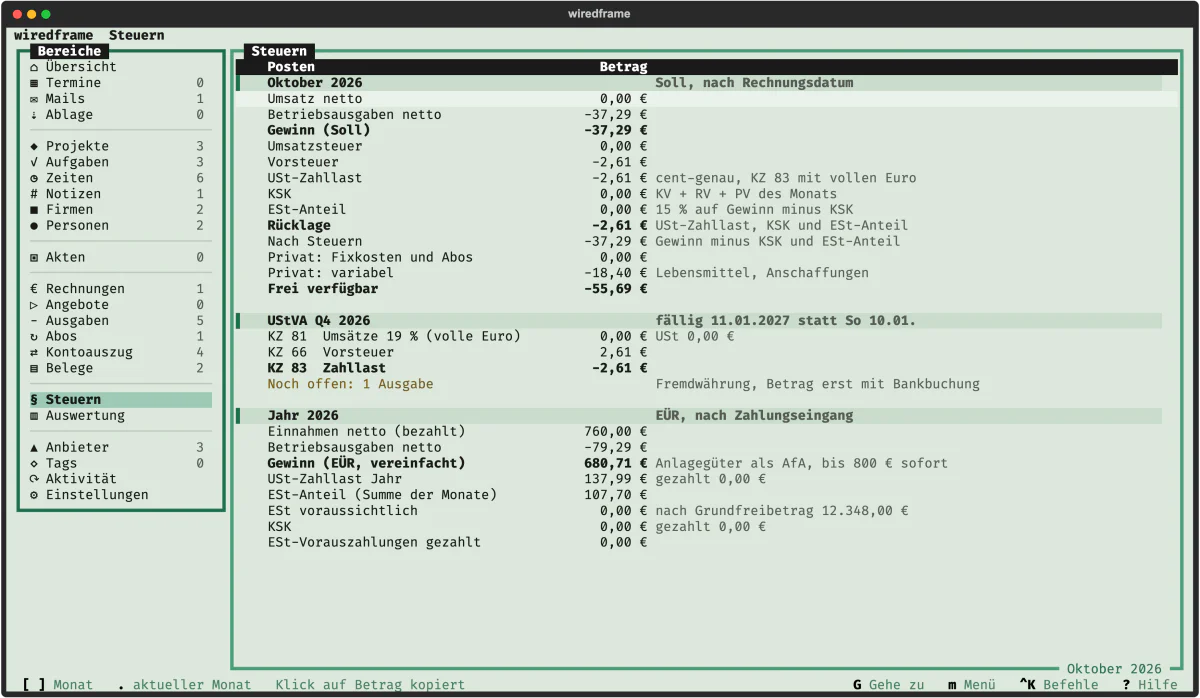
Was aus der Frage geworden ist
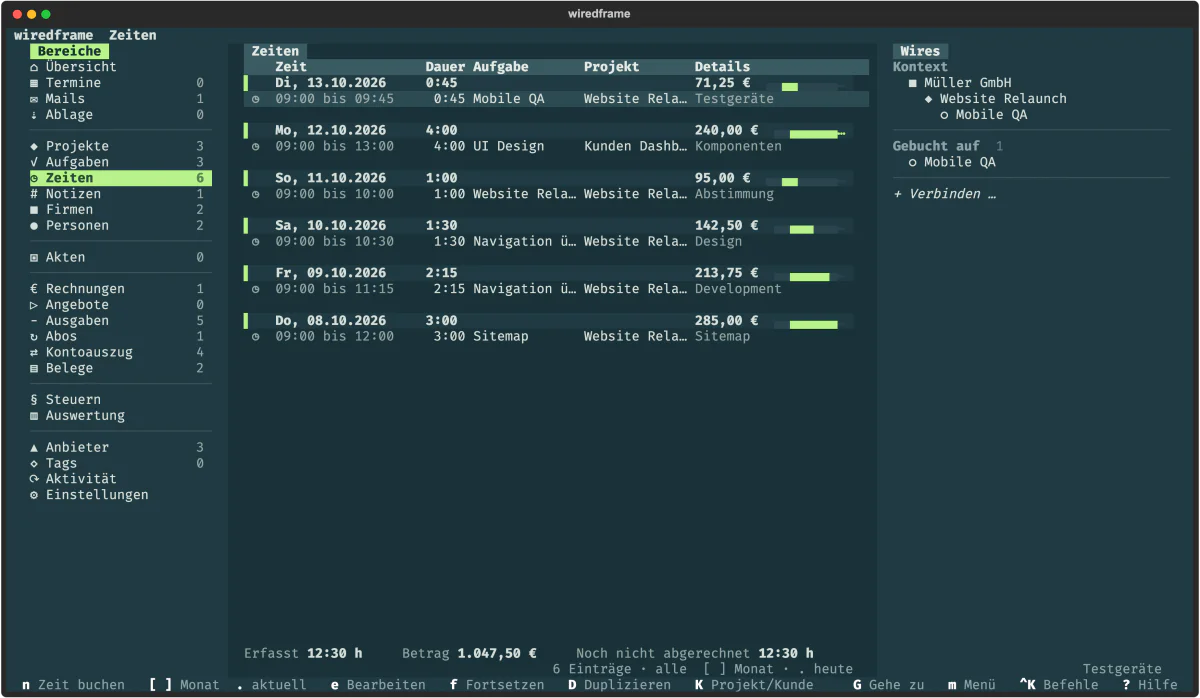
Zwischen der ersten Frage und heute liegen knapp drei Wochen, 581 Commits und 92 markierte Versionen. Die App hat etwa 27.000 Zeilen Python und 12.700 Zeilen Tests. Sie ist lokal, eine SQLite-Datei und ein paar Ordner, und sie redet mit meinen Konten nur über die Wege, die dafür am verlässlichsten sind. Warum welcher Weg, steht in der Architektur. Ich hatte Claude darum gebeten, weil sonst „in einem Jahr niemand mehr weiß, was mit was wie zusammenhängt“.
Die Funktionen waren der leichtere Teil. Viel mehr Zeit steckt in den Fragen danach. Was passiert, wenn die App zweimal läuft oder iCloud gerade schläft? Und was, wenn ich etwas zurücknehme, das schon zwei Schritte alt ist? Ich hätte diese Fragen allein nicht alle gestellt, und erst recht nicht beantwortet. Claude hat sie oft von selbst aufgebracht, die Agenten in den Nachtrunden noch öfter.
Ich habe dabei gelernt, was ein Savepoint ist, warum eine rowid keine Identität ist und warum man vor einer Migration lieber eine Kopie der echten Daten nimmt als die Testdaten. Immer an einer Stelle, an der es gerade wichtig war.
Und jetzt buche ich darin meine Zeiten, schreibe Rechnungen und lese Mails. Meistens denke ich nicht an Trigger und Grenzen im Stapel. Aber wenn ich Ctrl+Z drücke, weiß ich, dass es genau das tut, was es sagt.
Nachträge
Kleine Verbesserungen aus dem Alltag, jede mit ihrem Datum.
Ein Kontextmenü mit Ordnung (14. Oktober)
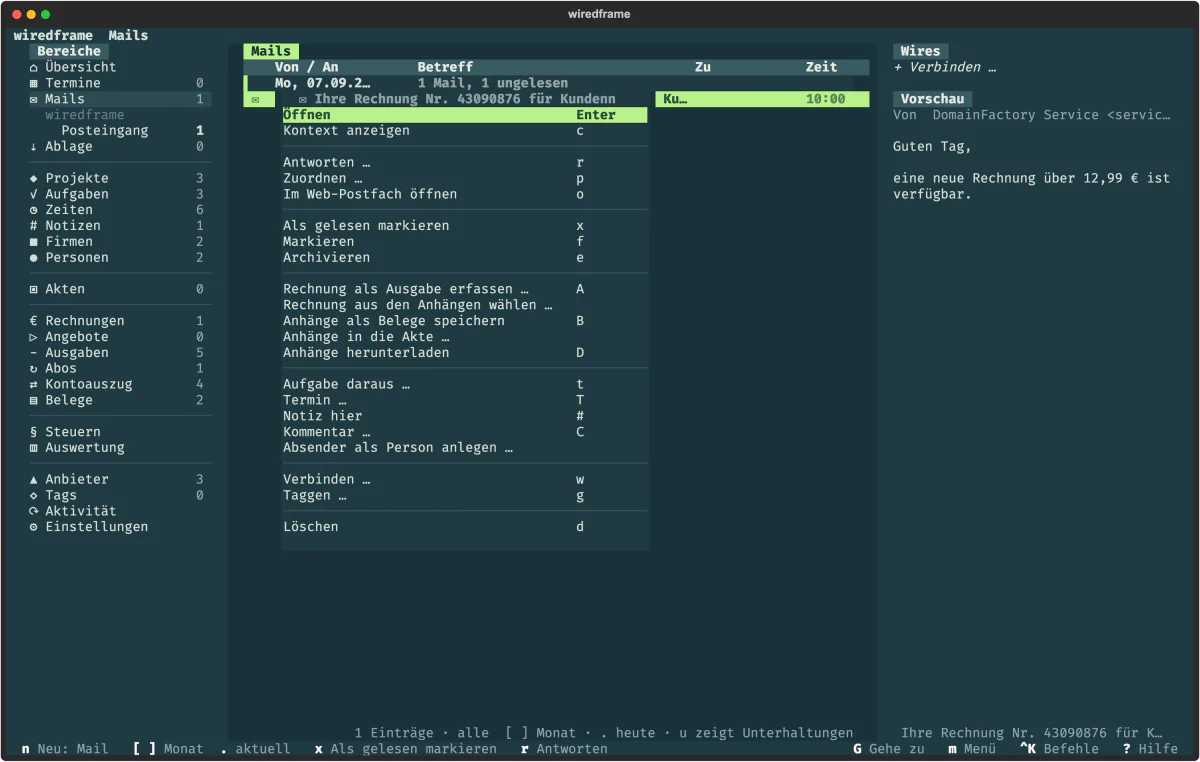
Jedes Modul darf Befehle an einen Datensatz hängen, und genau das hat das Menü einer Mail mit der Zeit unübersichtlich gemacht. Mail, Belege, Akten und Kontakte legten ihre Befehle alle in denselben Abschnitt „Aktionen“, sortiert wurde nur nach einer Zahl. So stand „Als gelesen markieren“ zwischen zwei Befehlen für Rechnungen, und „Kommentar“ hatte einen Abschnitt für sich allein.
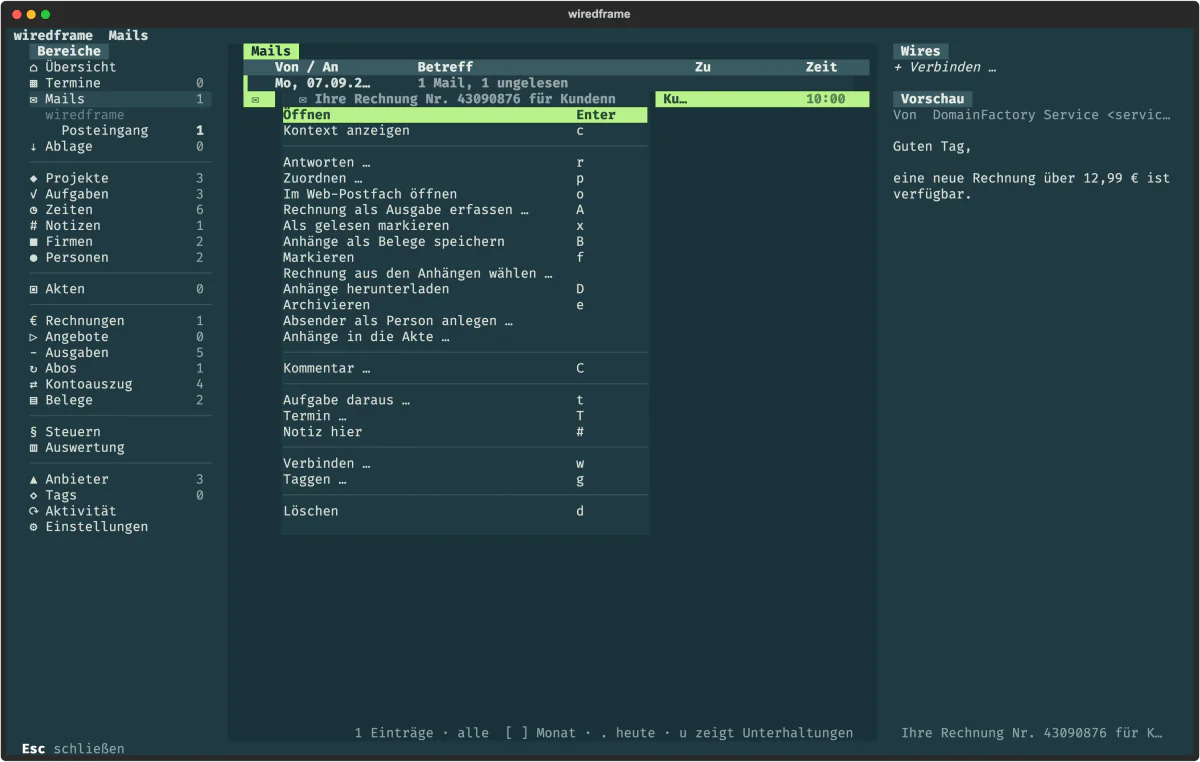
Jetzt gibt es feste Abschnitte, für alle Arten von Datensätzen in derselben Reihenfolge: zuerst, was man mit dem Datensatz tut, dann sein Status, dann Anhänge und Dateien, dann was daraus entsteht, am Ende Verbinden und Löschen. Ein Modul sagt nur noch, in welchen Abschnitt sein Befehl gehört. Die Tasten sind gleich geblieben, und die Leiste unten zeigt sie in derselben Reihenfolge wie das Menü.
Suchtreffer nach Datum (15. Oktober)
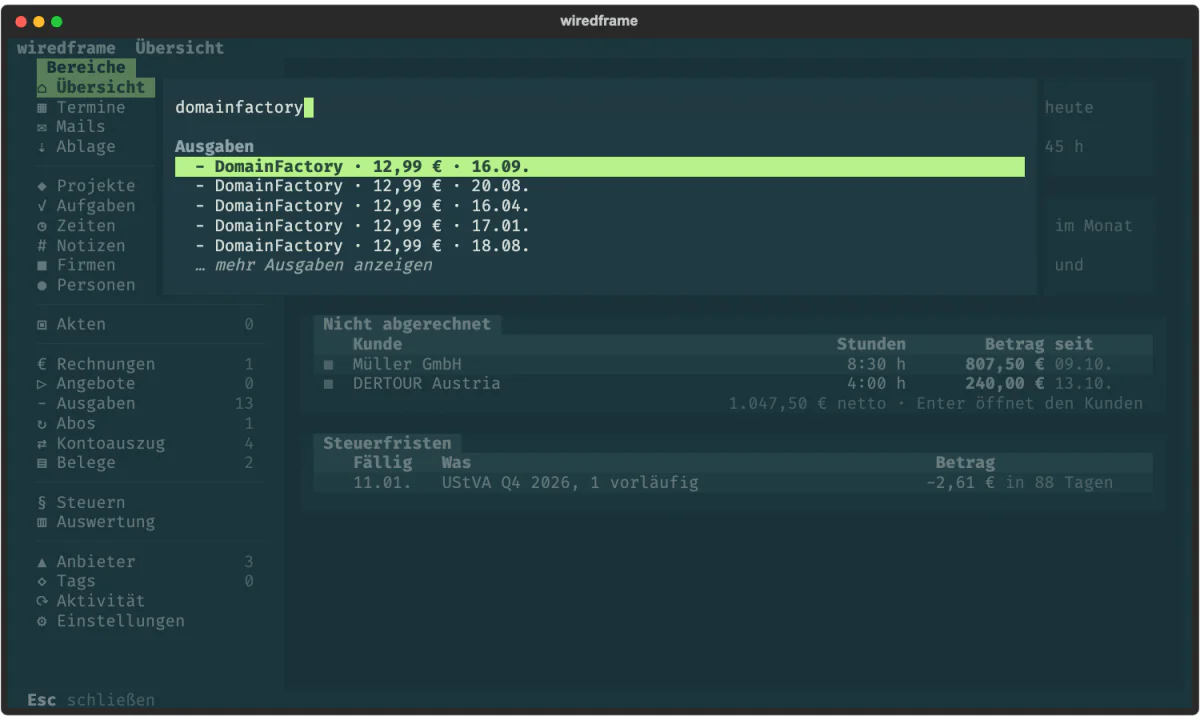
Die Suche (Ctrl+K) zeigt je Kategorie die ersten fünf Treffer. Welche das waren, entschied die Relevanz der Volltextsuche. Bei Belegen, Buchungen und Mails ist die aber fast immer gleich: fünf Rechnungen von DomainFactory passen alle gleich gut auf „domainfactory“. Heraus kamen fünf Treffer aus drei Jahren in zufälliger Reihenfolge, und die letzte Rechnung war oft gar nicht dabei.
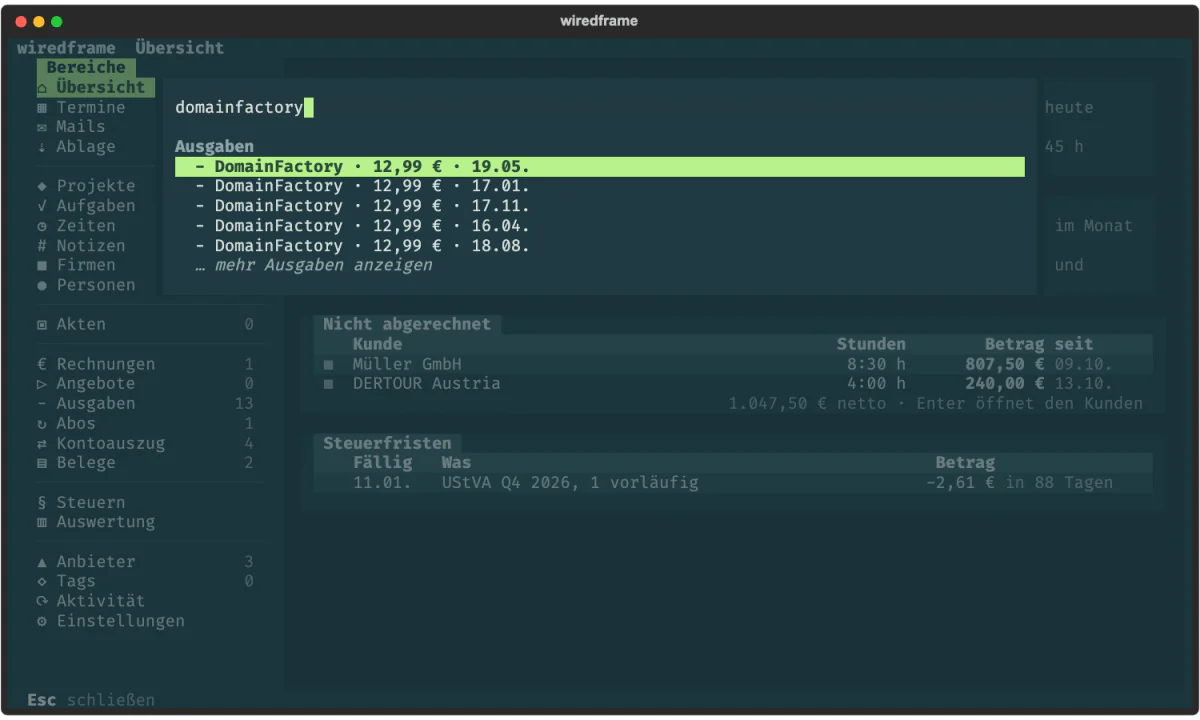
Jetzt sagt jede Art von Datensatz, welches Datum für sie zählt: bei Ausgaben das Belegdatum, beim Kontoauszug der Buchungstag, bei Mails der Eingang, bei Rechnungen das Rechnungsdatum, bei Zeiten und Terminen der Beginn. Danach sortiert die Suche, neueste zuerst. Firmen, Personen, Projekte und andere Stammdaten bleiben nach Relevanz sortiert, denn dort ist der Name wichtiger als das Alter.
Wann habe ich zuletzt von wem gehört? (19. Oktober)
Wer mit vielen Leuten gleichzeitig arbeitet, verliert manche aus den Augen. Nicht absichtlich, sie rutschen einfach durch, weil gerade andere lauter sind. Die Personenliste half dabei nicht: alphabetisch, ohne einen Hinweis, wann man zuletzt Kontakt hatte.
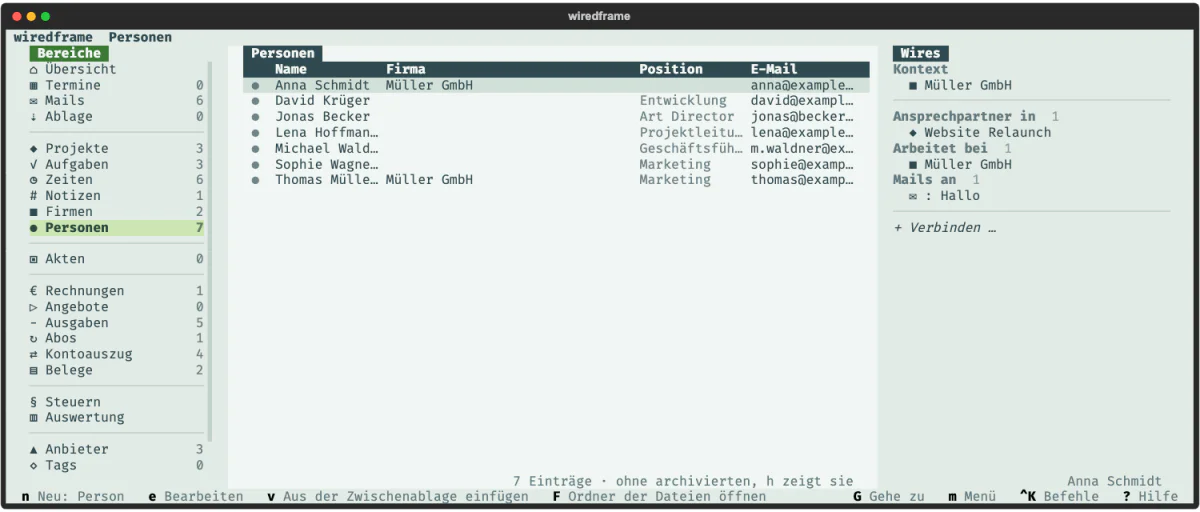
Die Daten dafür lagen schon da. Jede Mail hängt per Wire an Absender und Empfängern, jeder Termin an seinen Teilnehmern. Mail und Kalender melden jetzt je eine Kennzahl, „Letzte Mail“ und „Letzter Termin“ (nur vergangene, ein geplanter Termin ist noch kein Kontakt). Die Personenliste nimmt davon das Jüngste und sortiert danach. Oben steht, mit wem ich gerade im Austausch bin, und je weiter unten jemand steht, desto eher sollte ich mich mal melden. Stufen oder Fristen gibt es bewusst nicht, wie oft man mit wem spricht, ist zu verschieden.
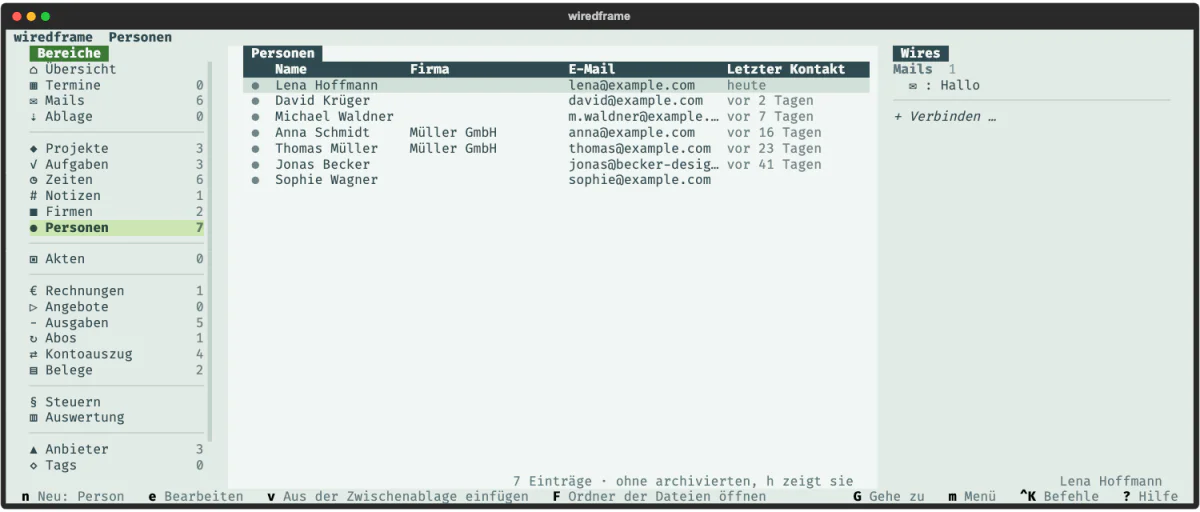
Von der Architektur her war das fast nichts: Kein Modul kennt ein anderes, die Kontakte lesen nur zwei Kennzahlen, die Mail und Kalender ohnehin über den Kontext beisteuern können. Eine gebündelte Abfrage war vorbereitet, an einer Kopie der echten Daten aber unnötig: 67 Personen brauchen 44 Millisekunden. Und weil Personen im Kontext ihrer Firma stehen, zeigt auch die Firma ihre letzte Mail und ihren letzten Termin.
Die unabhängige Prüfung danach fand trotzdem einen echten Denkfehler: Eine Einladung hängt am Termin, und über den Kontext galt sie als Kontakt mit allen Teilnehmern, auch wenn der Termin erst nächste Woche ist. Gezählt werden jetzt nur Mails, die wirklich von oder an die Person gingen, und Termine, an denen sie teilgenommen hat.
Acht Agenten, ein Abend Feinschliff (19. Oktober)
Drei Wochen im Alltag haben eine Liste kleiner Ärgernisse hinterlassen, die einzeln keinen Abend wert sind. Also wieder eine große Runde: acht Agenten, jeder mit einem Bereich (Mail, Termine und Personen, Zeiten und Aufgaben, Rechnungen, Bank und Steuern, Akten und Ablage, Navigation und Tempo, Kern und Kommandozeile), jeder in einem eigenen Arbeitszweig und mit einer eigenen Kopie meiner echten Daten, offline und mit umgebogenen Pfaden. Regel für alle: erst ein Test, der den Fehler zeigt, dann der Fix. Keine neuen Funktionen, nur Glätten. Danach haben zwei unabhängige Prüfer den zusammengeführten Stand durchgesehen und noch drei Fehler gefunden, darunter einen, den die Tests nicht sehen konnten.
Ein paar Beispiele.
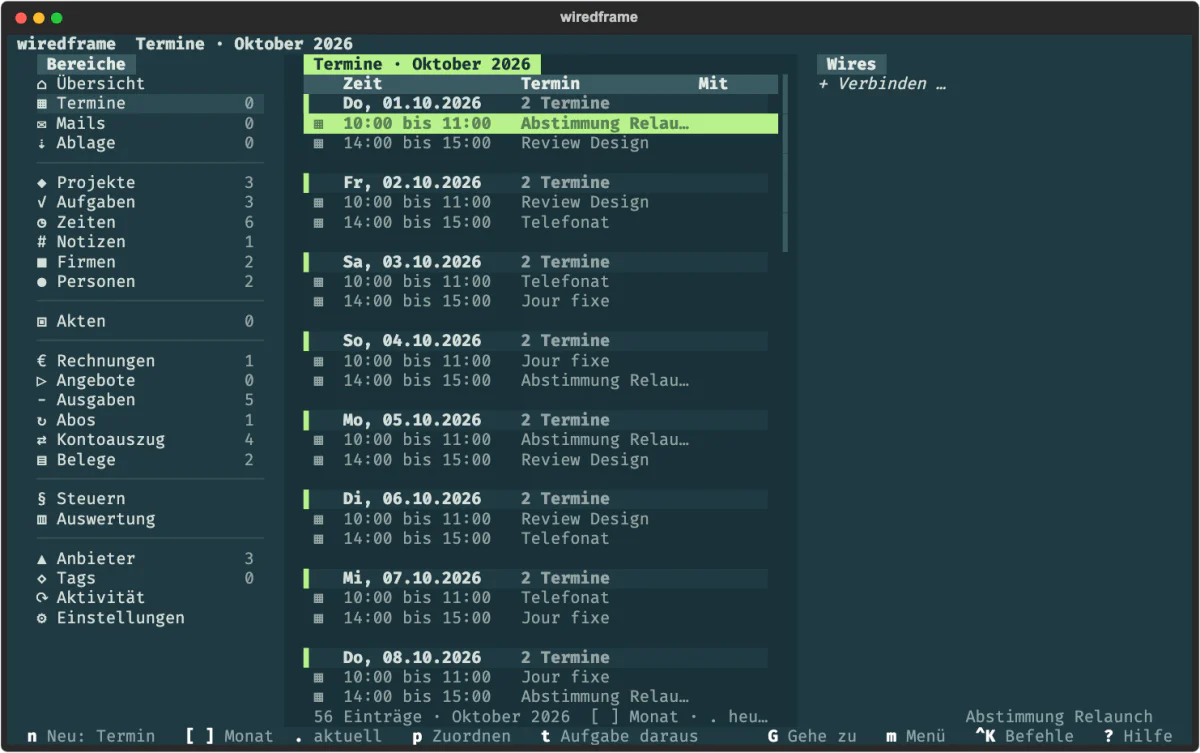
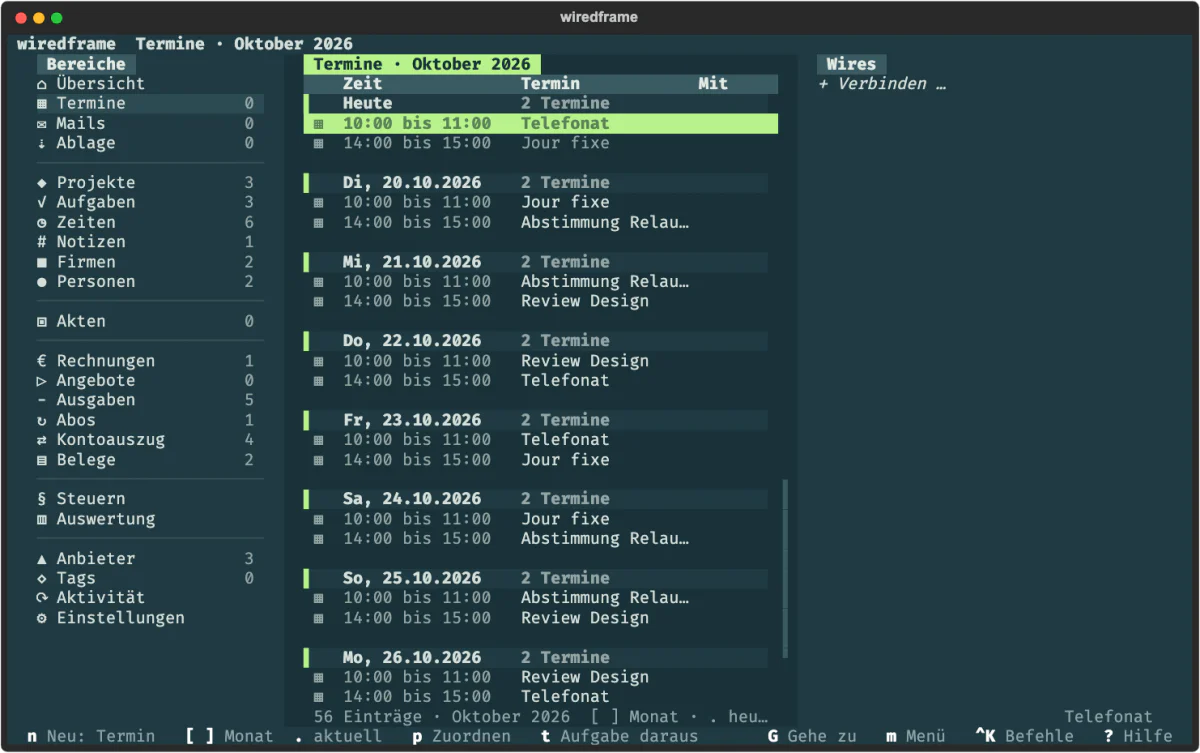
Termine fangen bei heute an. Öffnete ich die Termine, landete ich am Monatsanfang und musste erst zu heute scrollen. Jetzt steht der Cursor auf dem ersten Termin ab heute. Das gilt allgemein für jede Liste, die vorwärts durch die Zeit läuft.
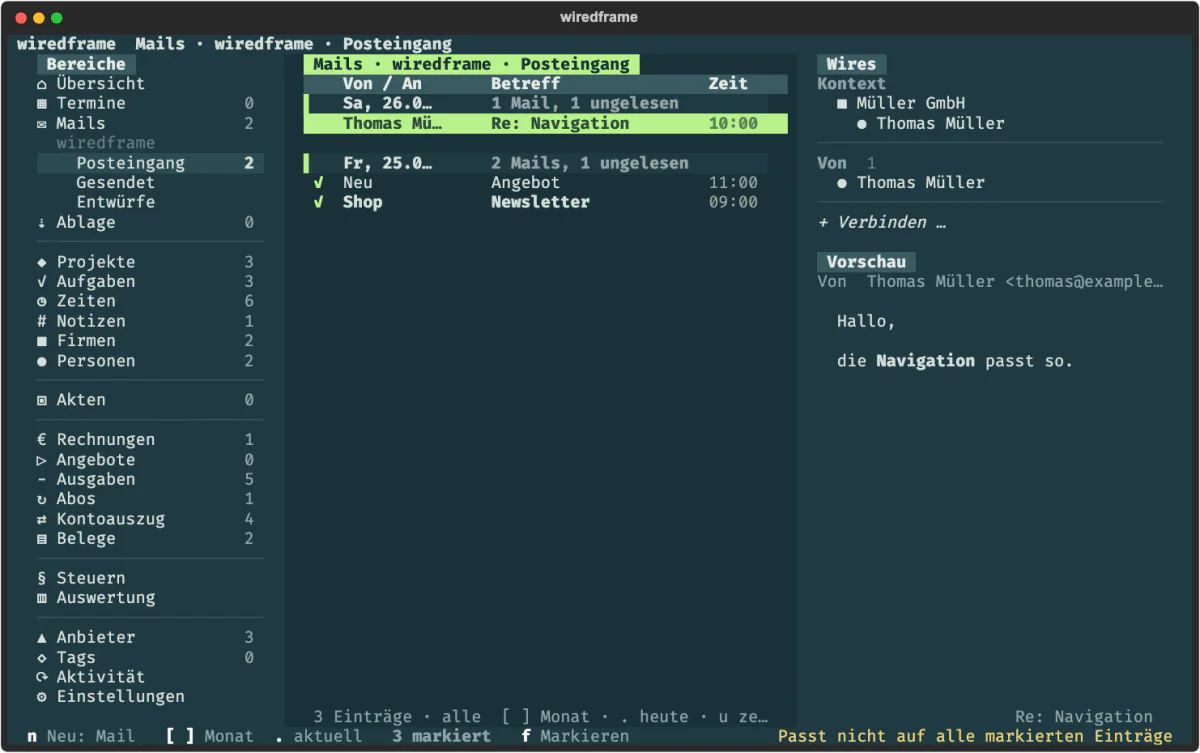
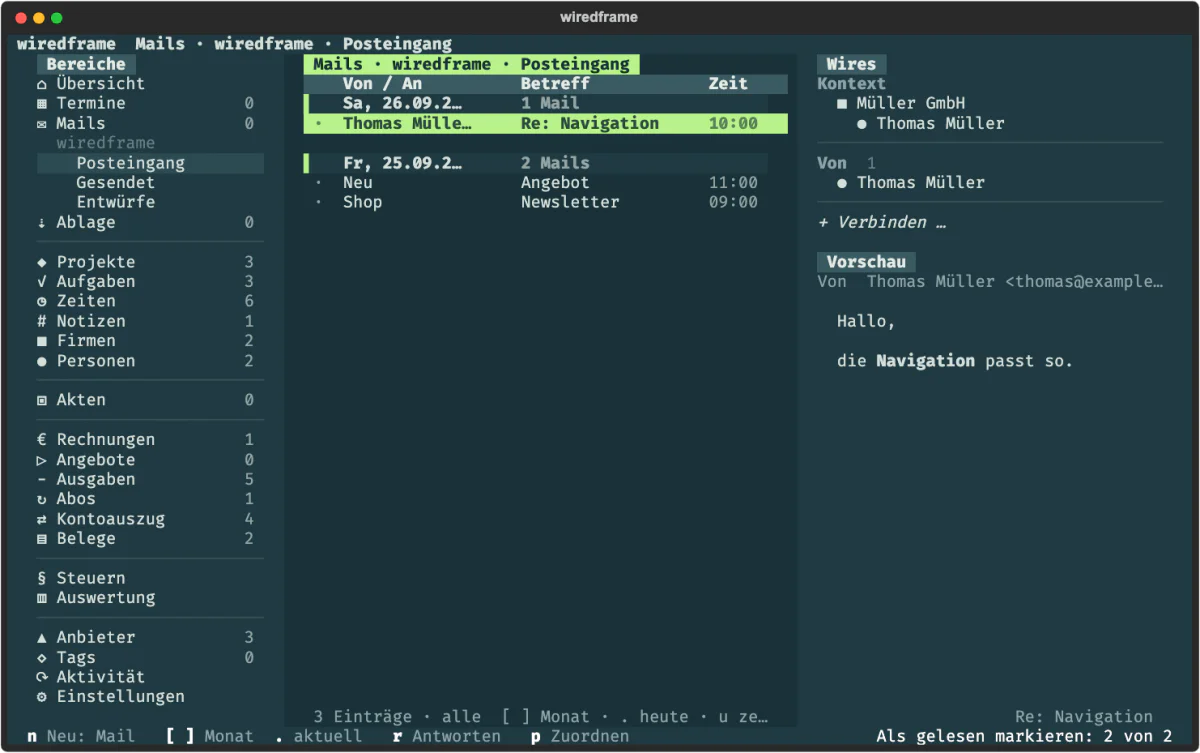
Gemischt markierte Mails. Hatte ich mehrere Mails markiert und waren manche schon gelesen, sagte x nur „Passt nicht auf alle markierten Einträge“. Jetzt macht x einfach alle gelesen, wie ich es aus jedem Mailprogramm kenne, und f markiert alle.
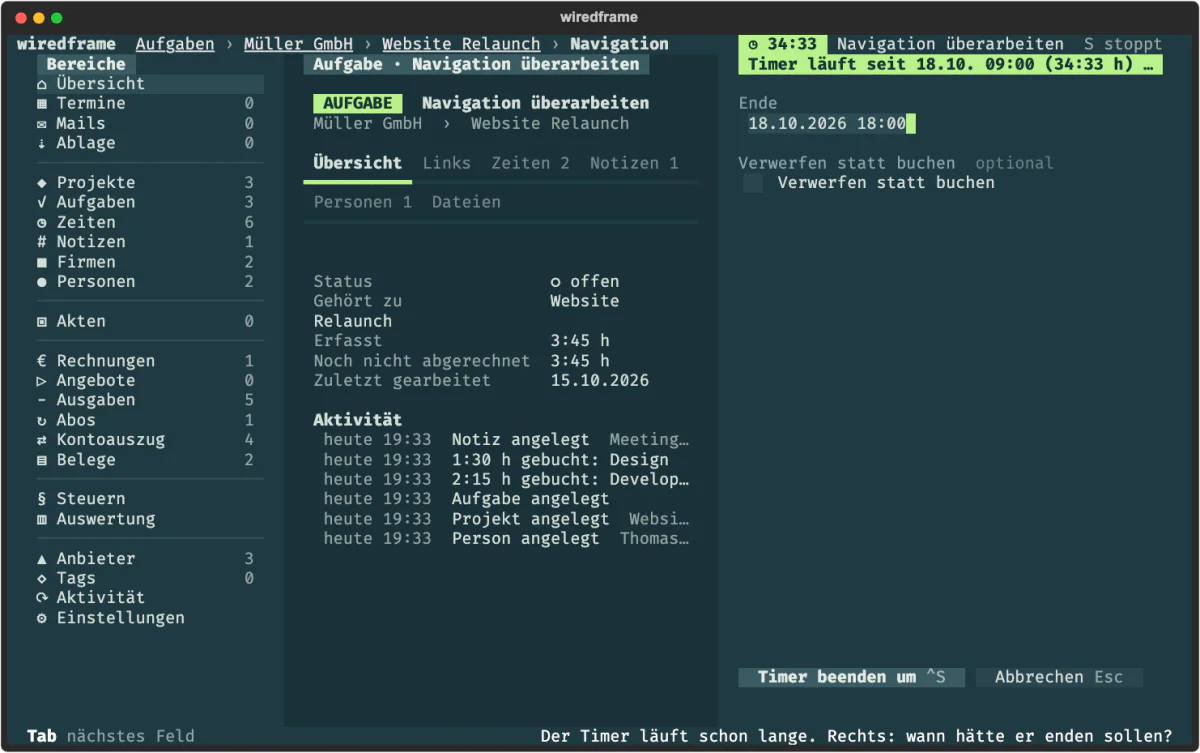
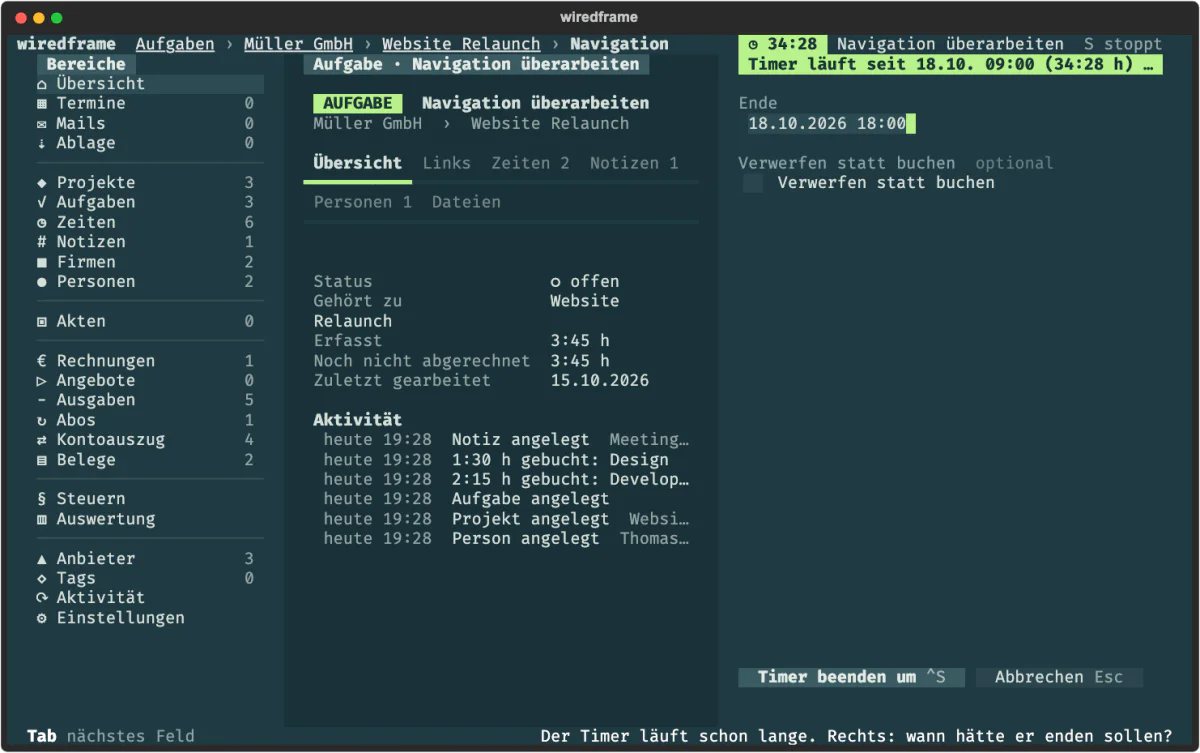
Der vergessene Timer. Lief der Timer seit gestern, sagte S nur, ich solle „Timer beenden um …“ benutzen. Den Befehl musste ich dann suchen. Jetzt öffnet S das Formular direkt mit einem vorgeschlagenen Ende. Kurz nach Mitternacht schlägt es außerdem die aktuelle Uhrzeit vor und nicht mehr eine in der Zukunft, und „90“ als Dauer wird nicht mehr still zu 90 Stunden.
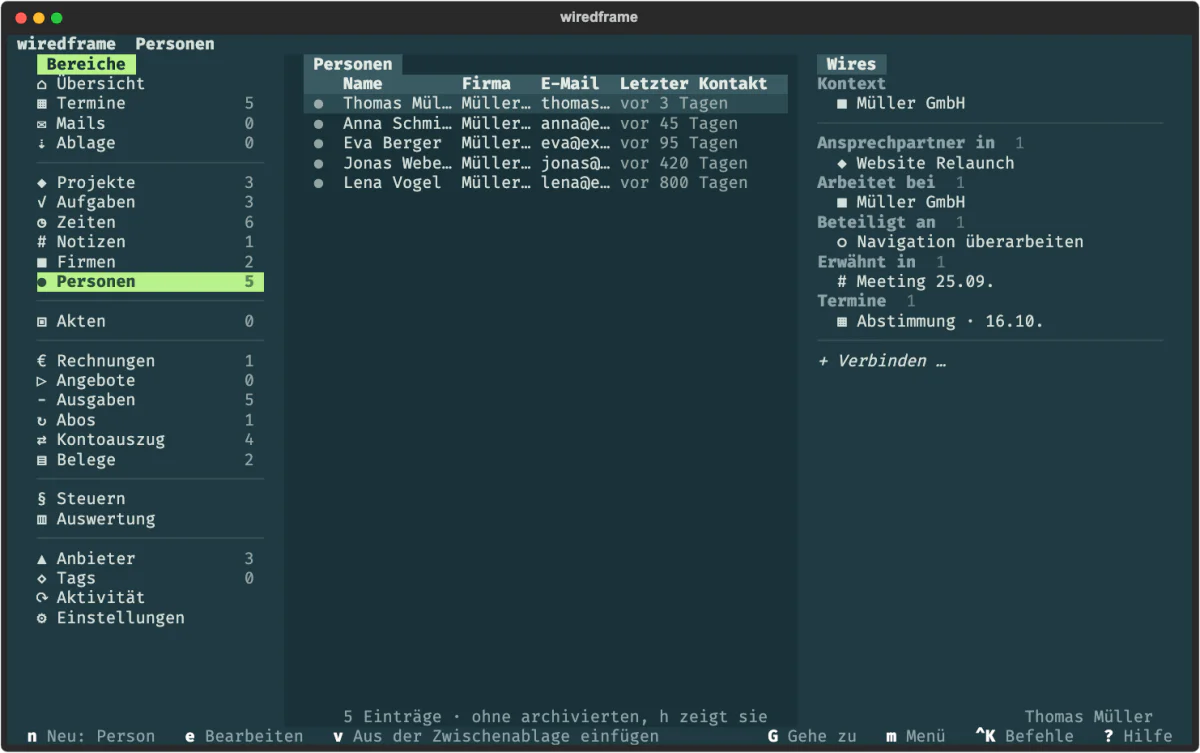
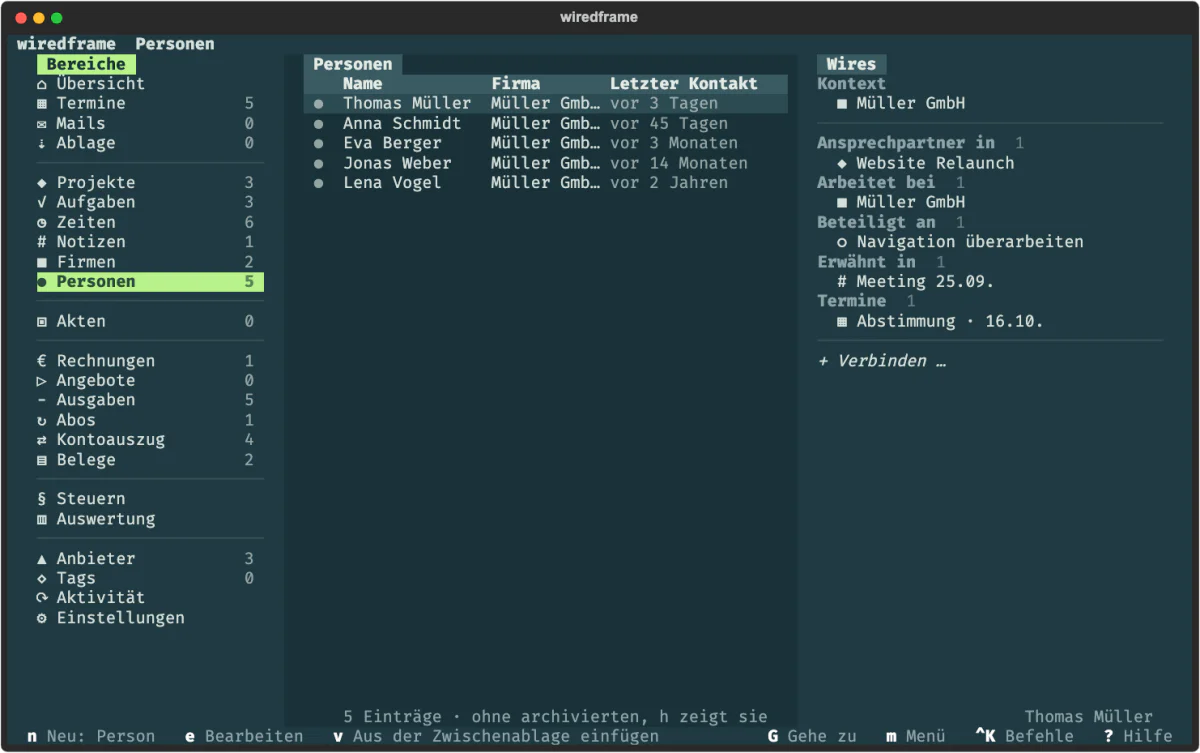
Letzter Kontakt lesbar. „vor 420 Tagen“ musste ich jedes Mal umrechnen. Jetzt steht da „vor 14 Monaten“. Wichtiger war ein Fund dahinter: Viele Termine hingen an keiner Person, weil der Kalender Teilnehmer oft nur als Mailadresse oder als „Nachname, Vorname“ liefert, und Personen, die ich nachträglich angelegt hatte, fehlten die eigenen gesendeten Mails. Beides ist behoben, und damit stimmt auch die Spalte.
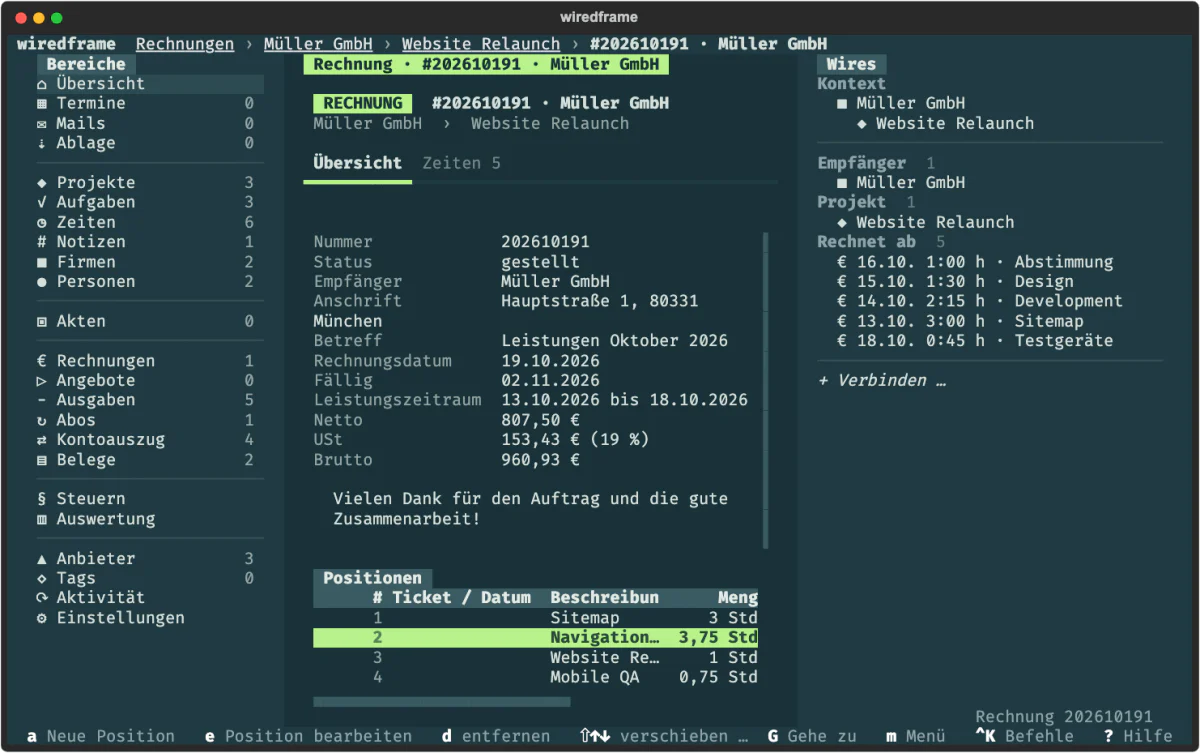
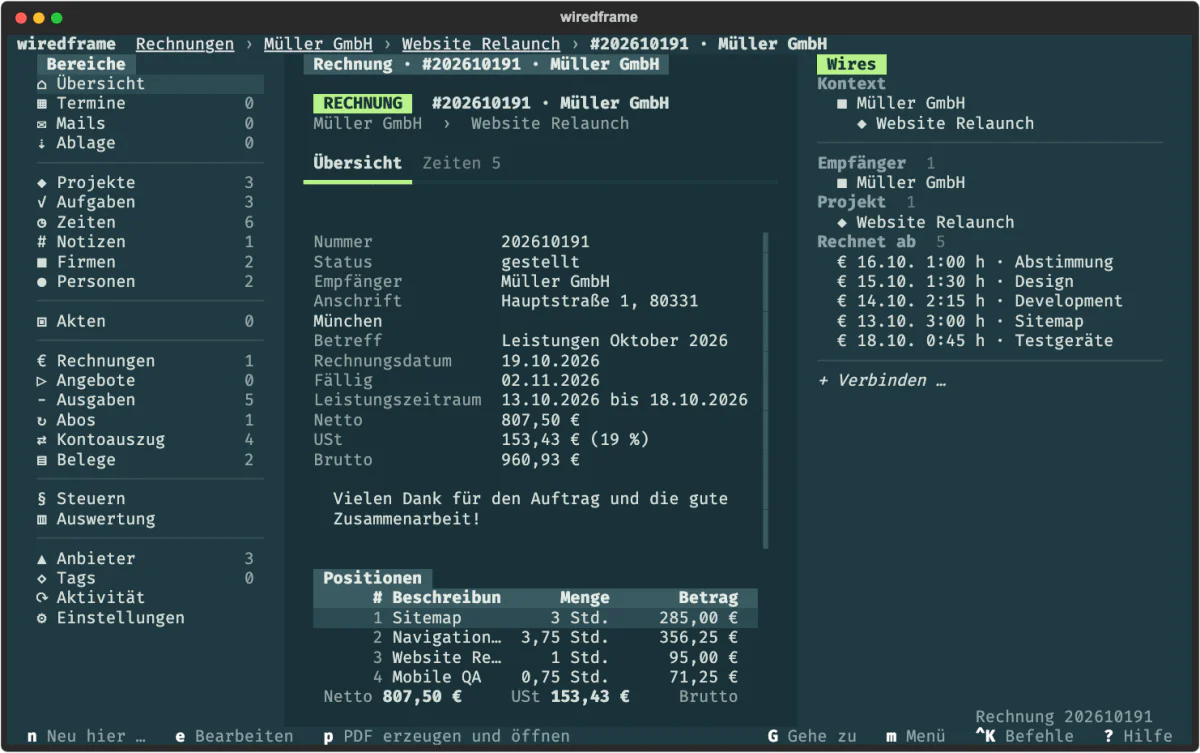
Positionen im schmalen Fenster. Ausgerechnet der Betrag rutschte rechts aus dem Bild, links stand dafür eine leere Spalte „Ticket / Datum“. Jetzt weichen bei Platzmangel zuerst USt und Einzelpreis, Menge und Betrag bleiben.
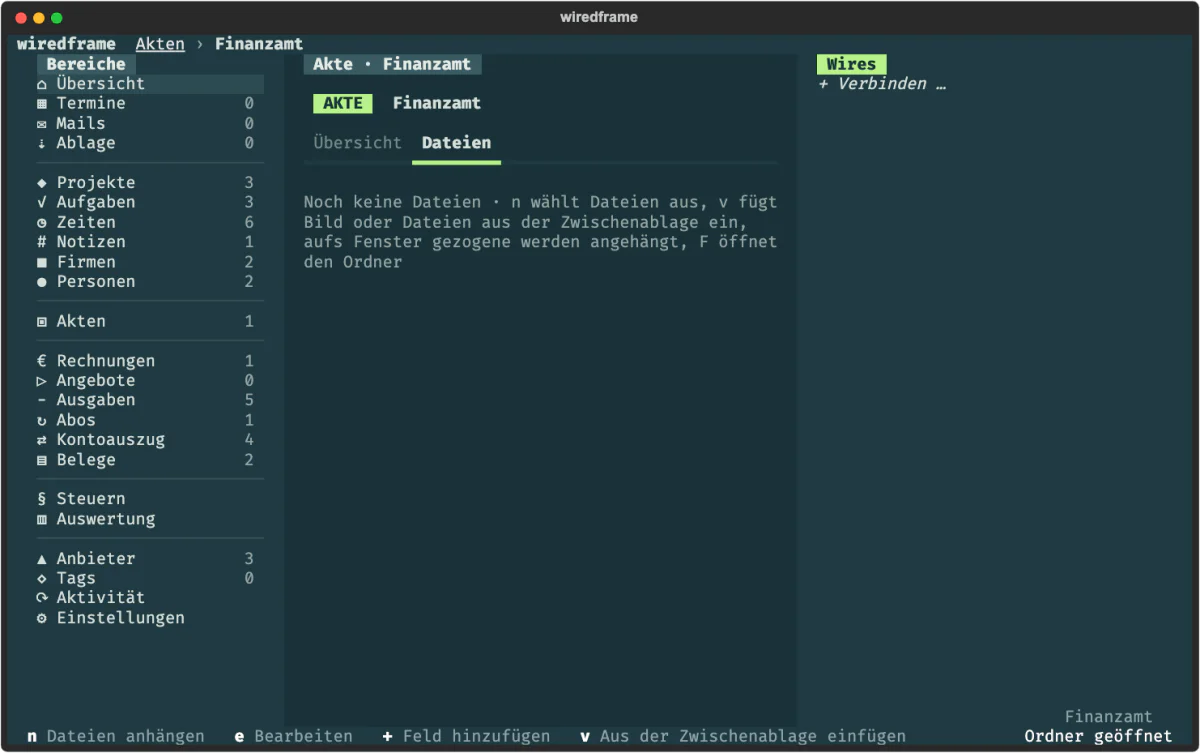
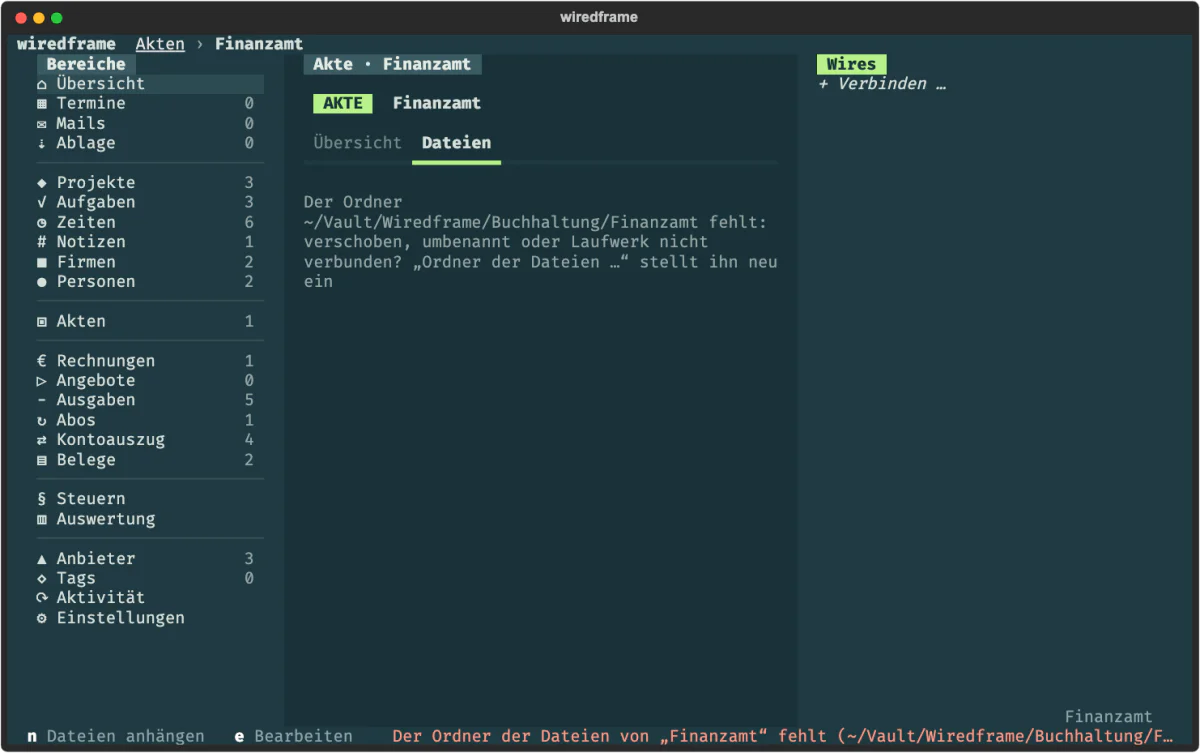
Ein fehlender Ordner wird nicht mehr still ersetzt. Hatte ich den Ordner einer Akte im Finder umbenannt, legte wiredframe beim nächsten Ablegen am alten Ort einfach einen leeren an, und meine Dateien lagen an zwei Stellen. Jetzt sagt der Tab „Dateien“, welcher Ordner fehlt.
Kleine Fenster. Die Summenzeile unter einer Liste schnitt ab, bei den Ausgaben stand „Vorsteuer“ ohne Betrag da. Jetzt bricht sie um, und unter einer einzelnen Zeile steht „1 Eintrag“.
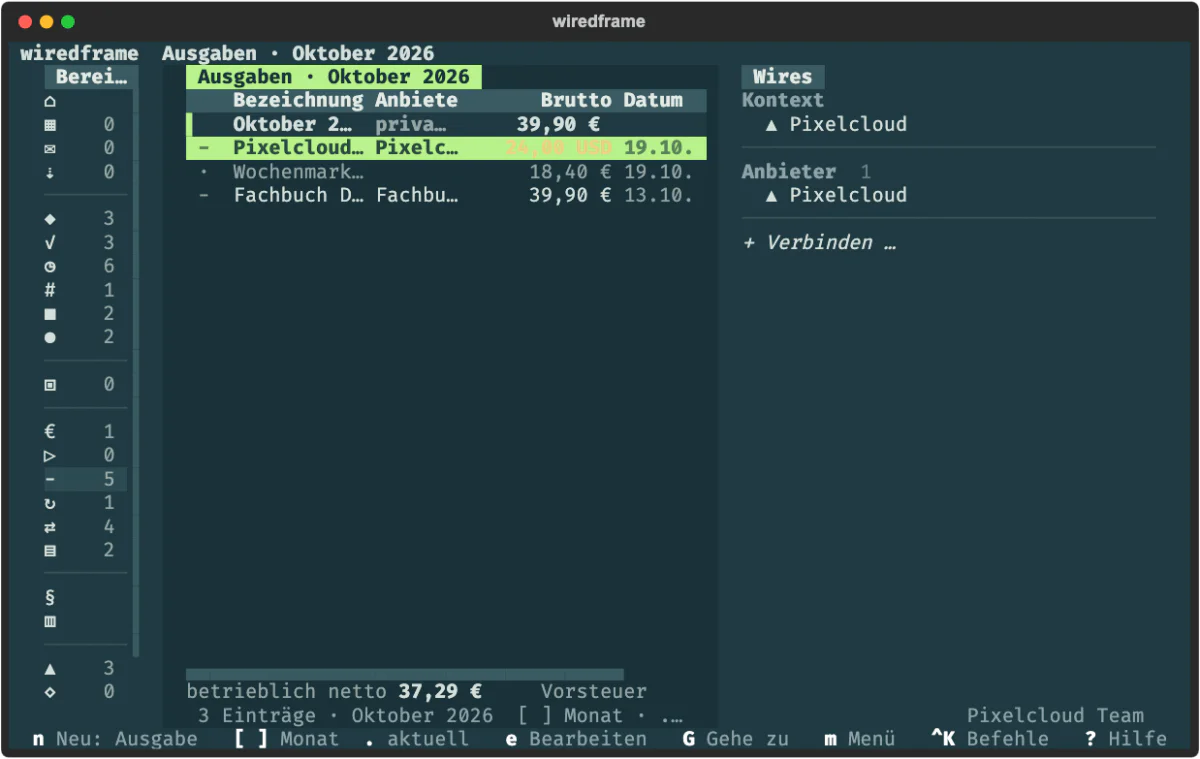
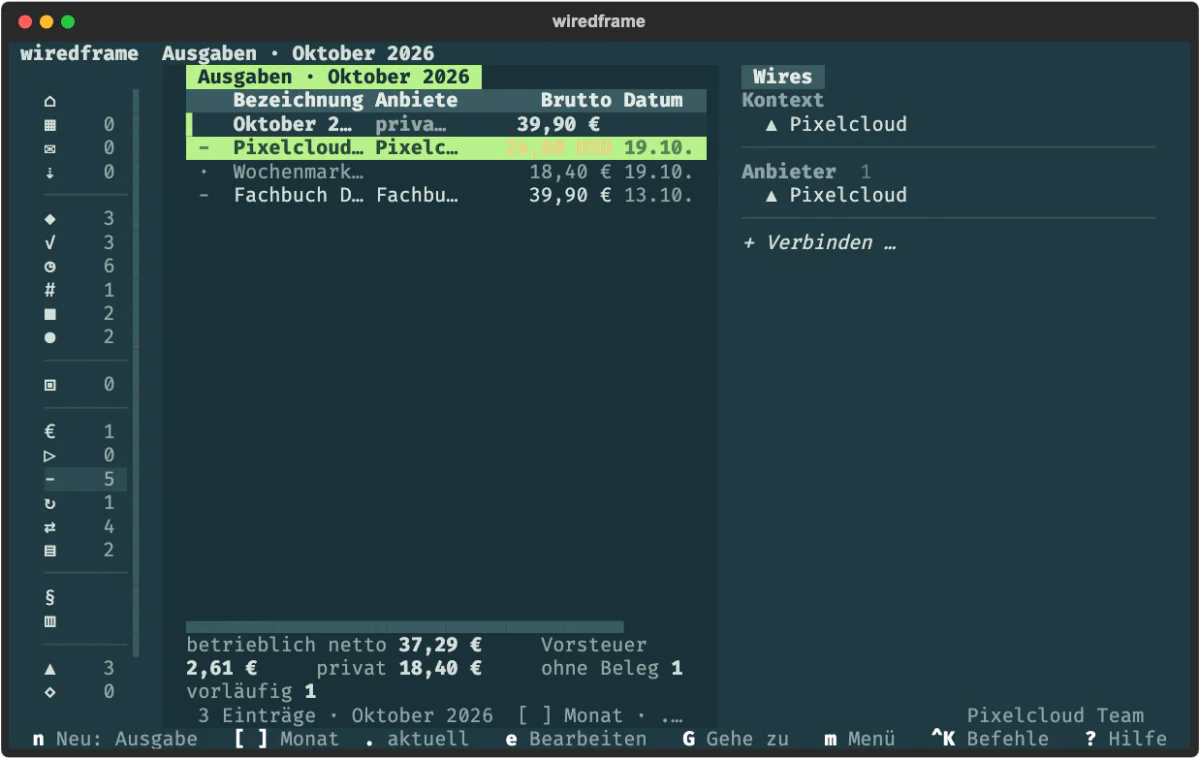
Vieles sieht man nicht. Ein Beleg landete still an der offenen Ausgabe vom Vorjahr, nur weil das Monatsabo gleich viel kostet. Zwei Überweisungen am selben Tag mit gleichem Betrag und der Bankreferenz „NOTPROVIDED“ wurden zu einer. Absender mit Komma im Namen („Baumgartl, Bernhard“) zerfielen beim Abruf, 56 Mails hingen deshalb an niemandem. wf restore hätte mit der falschen Datei alle Daten durch eine leere Datenbank ersetzt. Und das Öffnen eines großen Kunden ist etwa doppelt so schnell, der erste Buchstabe in der Suche rund viermal, weil wiredframe sich die Zusammenhänge jetzt bis zur nächsten Änderung merkt.
Am meisten gelernt habe ich aber aus dem, was die Agenten nicht ändern durften: In meinen echten Daten steht eine USt-Vorauszahlung über 500 €, zu der es keine Abbuchung gibt, und im Ordner der Ausgangsrechnungen lagen drei PDFs von Rechnungen, die ich gestellt und gleich wieder gelöscht hatte. Solche Funde entscheide ich selbst.